
Článek
Sedm dní práce se změnilo na dva a účtování použití chatGPT jako v loterii. Tak bych to stručně pojmenoval…
Ještě před několika týdny mi stejný typ práce v Codexu vydržel přibližně týden. Pracuji na několika webech / serverech a dalších projektech a používám podobný způsob práce jako dřív. Teď ale stejný kredit mizí během zhruba dvou dnů.
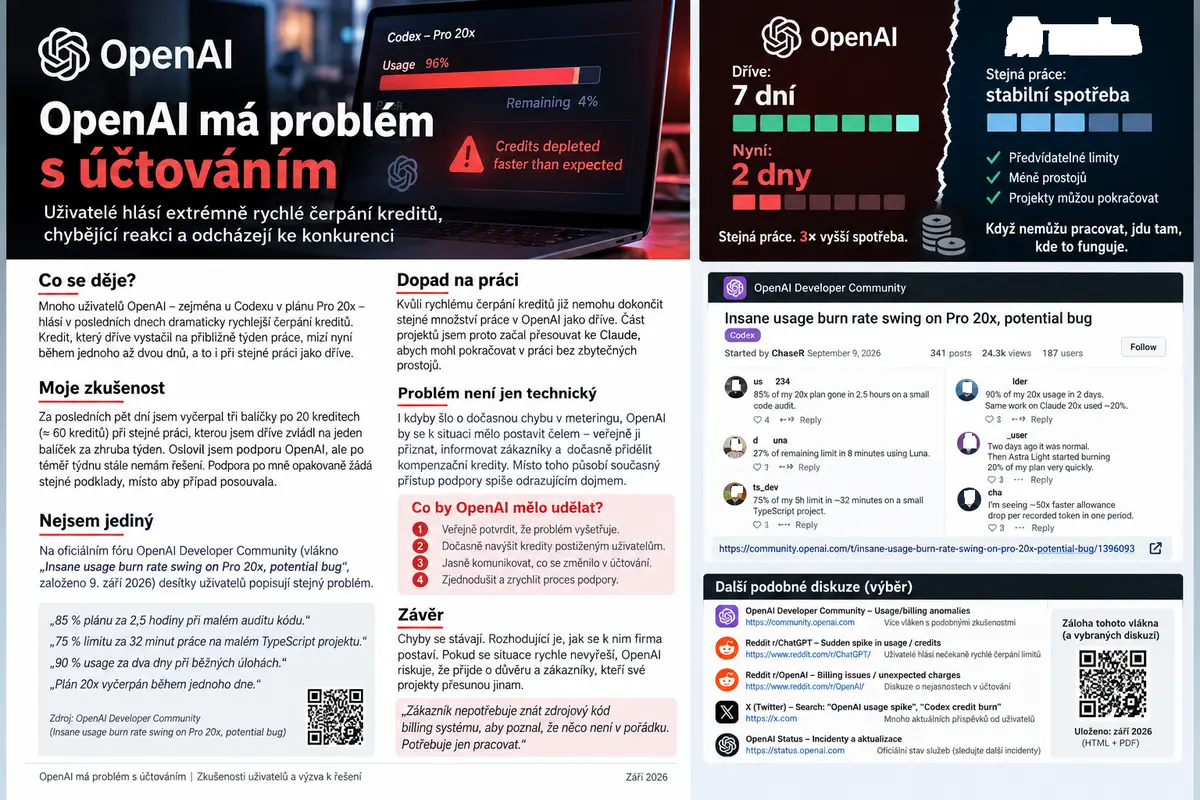
Za posledních přibližně pět dní jsem vyčerpal tři balíčky po 20× kreditech - kolem 60× standard balík kreditů - při práci, kterou jsem dříve zvládal s výrazně nižší spotřebou. Pro mě to není akademická debata o tokenech. Když kredit dojde, nemůžete opravit rozbitý web ani pokračovat v projektu pomocí AI - musíte pěkně ručně a to jak jistě uznáte, tak rychlé a efektivní není. Proto jsem se obrátil na podporu OpenAI. Ale ouha… Místo rychlého vyšetření jsem několik dní dostával další a další požadavky na screenshoty, session údaje a další podklady, často velmi podobné těm, které už byly poskytnuty. Po téměř týdnu jsem komunikaci vzdal. Na další dokazování stejného problému jednoduše nemám čas. Poslal jsem podpoře odkazy na fóra s diskusemi lidí se stejnými problémy a jal se přecházet jinam. A jen tak si zapátral.
Popravdě, skutečnost mi svou malebností až vyrazila dech… Nejde absolutně o izolovanou stížnost jednotlivců zmítaných nepřízní AI osudu. Na OpenAI Developer Community vzniklo 9. září vlákno „Insane usage burn rate swing on Pro 20×, potential bug“. V něm i v dalších veřejných vláknech uživatelé popisují velmi podobný vzorec: náhlé zrychlení spotřeby, které neodpovídá jejich předchozí zkušenosti nebo zaznamenané práci.
Poté další a další…
OpenAI Community 9. 9. 85 % plánu 20× za 2,5 h při malém
code auditu čas + plán
OpenAI Community 12. 9. 90 % ChatGPT 20× za 2 dny při
běžných úlohách před/po
OpenAI Community 13. 9. cca 75 % 5h limitu za ~32 min na
menším TS projektu workload
GitHub #44685 11. 9. weekly allowance 0→100 % za <9
h, přiložená telemetrie silná telemetrie
GitHub #44224 9. 9. zbývající weekly usage přibližně
78→3 % při lehké práci konkrétní stav
Reddit 11. 9. 5× plán za 7 h; stejné workflow
dříve 4–5 dní anekdotické, kdy autor už asi raději než pláč zvolil formu humornou…
a mnoho dalších
Tato hlášení sama o sobě neurčují přesnou technickou příčinu. Mohou souviset s meteringem, vážením modelů, zpožděným zúčtováním, cache, subagenty nebo jiným mechanismem. Množství nezávislých hlášení v krátkém období je ale dostatečný důvod, aby se problém řešil jako incident, ne jako série izolovaných nedorozumění.
Největší problém je podle mého reakce firmy a to stojí za zmínku, není to žádná parta nazdárků v garáži a už vůbec nemanipulují s úplně bezpečným materiálem - ne nebudu tu vysvětlovat , jak funguje Ai , ale když řeknu, že globálně umíme pojmenovat tak cca 3-5% toho, co se děje uvnitř uzavřené kostky s datakrokodýly, kam házíme datové slepice a kde nám vypadávají výsledky typu datavejce (teď jsem to hooodně zjednodušil pro laiky a ne každý bude souhlasit, ale to není point…) - tak možná nepřeháním. Ne fakt to není jako klasická práce programování a fakt víme málo a je to fakt v určitým úhlu pohledu děsivý…
Ono…
Technická chyba se může stát každé firmě. Zákazník ale potřebuje vědět, že o ní poskytovatel ví a že ho nenechá bez pracovního nástroje, zatímco probíhá vyšetřování.
Podle mé zkušenosti se to neděje. Podpora mě nutí znovu a znovu dokládat údaje, zatímco veřejně existují další velmi podobná hlášení. Z pohledu zákazníka má takový proces odrazující účinek: místo práce tráví další hodiny dokazováním, že jeho historicky stabilní spotřeba se náhle změnila. A dny bez kreditů běží a projekty stojí......
OpenAI by podle mě měla veřejně potvrdit, že podobná hlášení vyšetřuje, sjednotit komunikaci podpory a postiženým uživatelům promptně dočasně přidat kredity nebo limity nebo co já vím co , ale hlavně umožnit práci. Úsměvné je, že navíc jeden z uživatelů hlavního vlákna uvedl, že mu usage bylo následně opraveno zpět na 81 %, takže minimálně některé korekce serverového stavu nastat mohou a při dobré vůli se dějí.
Výsledek zcela a úplně překvapivý: projekty se přesouvají ke konkurenci
I já bohužel už jsem s přesunem části práce začal. Ne proto, že bych chtěl vést válku značek, ale proto, že potřebuji dokončit práci. Pokud Ai X vyčerpá kredit za dva dny a další projekt musí čekat, a podpora nepodporuje, nýbrž zdržuje cirkulací vyžadování nesmyslných důkazů o vlastní aplikaci, tak hledám nástroj, se kterým mohu pokračovat.
Paradox je zřejmý: problém s náklady mě donutil důkladněji vyzkoušet nejmenovanou AI Y a zjistil jsem, že některé projektové úlohy tam fungují velmi dobře. Firma, která nechá zákazníka bez předvídatelného přístupu k práci, ho -světe div se- sama nutí otestovat konkurenci.
Pro zákazníka není podstatné, zda interní audit nakonec prokáže billing bug, změnu vah nebo jinou příčinu. Podstatné je, že stejný rozpočet nyní nepokrývá stejnou práci. A pokud se to děje většímu počtu lidí, nestačí každého jednotlivě posílat na další kolo dokazování.
„Zákazník nepotřebuje znát zdrojový kód billing systému, aby poznal, že kredit, který mu dříve vydržel týden, je dnes pryč za dva dny.“
Co je pod balvanem ?
Co by měla OpenAI udělat a teda fakt nedělá
• Veřejně potvrdit, že zběsilé změny Codex usage u části uživatelů vyšetřuje.
• Dočasně kompenzovat postižené účty kredity nebo navýšeným limitem, aby mohly pokračovat v práci.
• Zveřejnit srozumitelnější vysvětlení, jak se model, effort, cache, nástroje a subagenti promítají do allowance.
• Sloučit opakovaná hlášení do jednoho incidentu a přestat po každém zákazníkovi znovu požadovat prakticky totožnou sadu důkazů.
Co z toho plyne za ponaučení ? Vlastně nic nového, kdo může, ignoruje zákazníky jak může, až to jednou přežene a ti mu utečou jinam. Otázka je ale teď ještě zajímavěší v kontextu posledních událostí - děje se něco, co nedovoluje řešit další „menší“ problémy aka jedná se o hloupost, chamtivost, neschopnost nebo o něco závažnějšího v pozadí ? Hodnocení nechám na vás.....
Pokud se takhle tvůrci AI staví k jednoduchým problémům, co nás asi čeká, až něco vážně poto…
No vždyť se uvidí, obecně vzato, historie nás znova a znova učila, že opicím revolver do ruky nepatří a stejně jsme se nikdy nepoučili .......
Zdroje a veřejná hlášení
OpenAI Developer Community – hlavní vlákno
OpenAI Developer Community – Usage does not compute right
GitHub openai/codex #44685
GitHub openai/codex #44224
GitHub openai/codex #44278
GitHub openai/codex #44876
Reddit – Just don't use codex today
Reddit – quota burning ~1.7× faster
a mnoho mnoho dalších…
Poznámka k důkazům: Veřejné příspěvky jsou jednotlivá uživatelská hlášení, nikoli forenzní audit účtování. Jejich význam spočívá v množství, časové shodě a opakování stejného typu problému. Přesná technická příčina zůstává bez interních dat OpenAI neověřená. Článek vyjadřuje autorovy subjektivní pocity a závěry, BTW všimli jste si, jak se Ai agent občas zcela náhodně zablokuje, přemýšlí a nic neudělá, když jde o citlivé téma ?… no nic… Zajímavost, slovo SKYNET ve štítcích / TAGS nejde nalézt :) (zatím)


